为什么 Midjourney 经常生成乱码单词?无损修复 AI 绘画文字的完整指南
深入解析 Midjourney、DALL·E 3、FLUX 和 Stable Diffusion 为什么拼不对英文字母,以及如何在不重新抽卡跑图的前提下,30秒无损修正 AI 图像中的错别字与乱码。
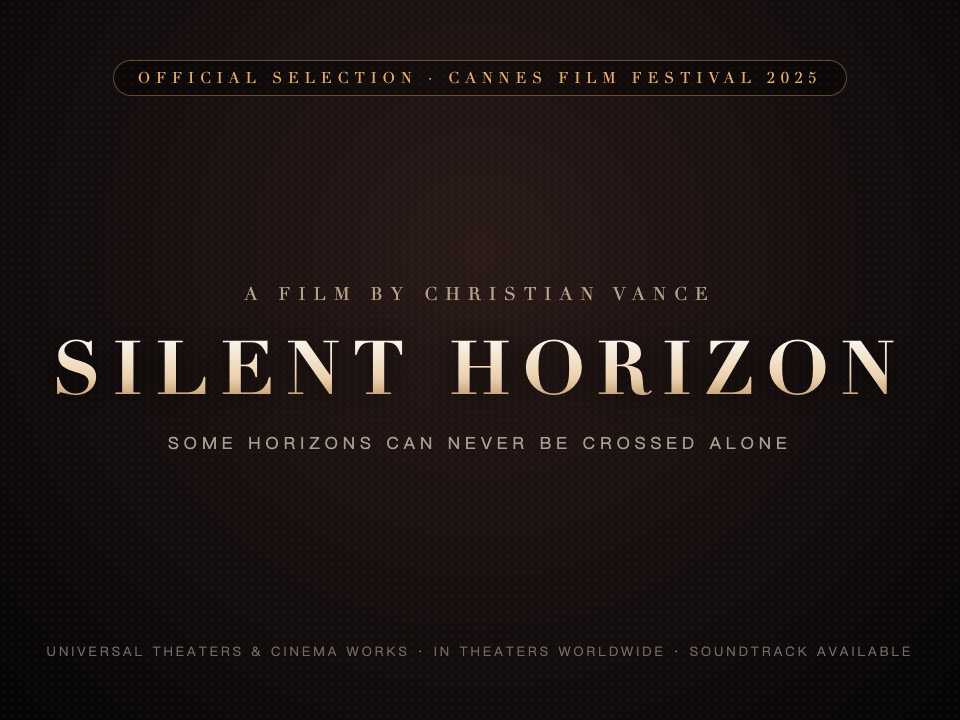
经常玩 Midjourney、FLUX、Stable Diffusion 或 DALL·E 3 的创作者一定对这种场景深恶痛绝:
你好不容易调出了一个绝美的复古咖啡馆插画或赛博朋克街景,构图、色彩、光影、人物氛围都堪称完美,偏偏挂在正中间的招牌上赫然写着 COFEFE 或者一串无法辨识的外星火星文。
这时候你面临两难:
- 重新跑图抽卡:哪怕加上相同的 Seed 种子,重新生成的画面构图和光影也全变了,原本心动的画面彻底报废,白白烧掉显卡算力;
- 自己用 Photoshop 修:你手头根本没有与原图画风、木纹质感、霓虹发光完全一致的字体,硬盖上去像贴了一块丑陋的补丁。
为什么世界上最先进的 AI 绘画大模型,连最基础的几个英文字母都拼不对?又该如何在保留原图艺术风格的前提下完美修复错字?本文将为你揭示技术真相并提供最快解决方案。
为什么 AI 绘画模型总是把单词拼错?
很多人以为 AI 画图就像在电脑里打字,实际上两者的原理天差地别:
1. 扩散模型把文字当“材质”,而不是“字符”
扩散模型在去噪生成图像时,它的核心任务是预测像素的概率分布。在它的“认知”里,招牌上的文字线条和树木的年轮、水面的波纹、衣服的褶皱没有任何本质区别——它们都只是一串带有明暗对比的视觉纹理。 因为模型内部没有一本拼写词典,它只知道“这里应该出现类似英文字母的线条形状”,于是极易画出笔画缺失、字符粘连或前后颠倒的伪文字。
2. 文本编码器(CLIP / T5)的信息压缩瓶颈
提示词输入后,会被编码器压缩为数学向量。虽然编码器能理解“复古招牌”的概念,但在层层注意力机制压缩中,具体每个字母的严格先后顺序被弱化了。模型知道要画字,但常常把 COFFEE 拼成 COFEFE。
创作者修复 AI 错字的 4 种途径对比
| 修复手段 | 耗费精力与时间 | 画风与构图保真度 | 综合成本 |
|---|---|---|---|
| 重新抽卡跑图 | 极高(反复重试十几次) | 极差(构图完全打碎重来) | 严重浪费 GPU 点数 |
| 平台内局部重绘(Inpainting) | 中等 | 碰运气(经常重绘出新的乱码) | 消耗额外生成额度 |
| 传统 Photoshop 手工修图 | 极高(需找字体、做光影滤镜) | 取决于个人设计功底 | 耗时且需付费软件 |
| 专属 AI 原位文字修复(PhotoTextEdit) | 30 秒一键出图 | 完美(保留原图光影、纹理与透视) | 免费试用 / 几分钱 |
实操教程:30 秒无痕修复 AI 绘画错字
告别反复抽卡,使用 PhotoTextEdit AI 绘图修字工具,可以在原图基础上定向替换错误单词:
第一步:上传带有错字的 AI 图片
访问 修复 AI 绘图文字专页,上传你的 Midjourney、FLUX 或 SD 生成的图片(支持 PNG、JPG、WebP,最大 10MB)。
第二步:输入错词与正确词汇
- 在**原图文字(Original Text)**栏,照着画面上的错字原样输入(例如
COFEFE CLUB); - 在**替换新词(New Text)**栏,输入正确的拼写(例如
COFFEE CLUB)。
第三步:AI 智能重绘并下载成品
点击生成,算法会执行以下步骤:
- 精准定位错字所在的像素边界;
- 无痕擦除错字,自动还原其背后的木纹底板或霓虹背景;
- 依据原图艺术风格,用完全相同的光泽、立体厚度、发光衰减与透视角度,重新绘制出正确的新单词。
获取最佳效果的 3 个实用技巧
- 新词字数尽量接近:如果原图画错的词是 6 个字母,替换词也在 5–8 个字母之间,排版比例最为和谐自然。
- 多处错字分批处理:如果一张图上有两个分散的标语都拼错了,分别进行单次替换,效果往往比一次性提交多行字更加干净利落。
- 复杂艺术字开启 Pro 模式:如果文字具有浓重的赛博朋克霓虹外发光、金属倒角或哥特手写体,建议在提交时选用 Pro 模式以获取最佳字体细节。
现在就去试试 修复 AI 图像文字,拯救你那些原本心动却因错字报废的 AI 画作吧!